
主题
部署实践|从零开始在 UniLab 上训练 T800 WalkFlat:从环境检查到 SAC 完成
这篇文章通过在算力自由平台验证,把本机一次真实、可复核的 UniLab + MuJoCo + T800 WalkFlat 训练记录整理成一条完整链路: 安装环境——确认任务——理解机器人和控制方式——做小规模试跑——启动正式 SAC 训练——查看训练曲线——验收模型和回放视频。
先给结论:
- 本机已经有一条完整的 SAC 记录:
10,000iterations、20,500,480environment steps,run_summary.json状态为completed。 - 这次完整训练使用
2,048个并行环境,在 RTX 4090 上跑通;训练阶段耗时310.60 s,含回放和收尾的完整 wall time 为339.10 s。
本文的主实验是 Manager-Based T800 WalkFlat + MuJoCo + SAC。
1. 实验快照:先固定“我到底跑了什么”
正式 SAC run 的目录是:
logs/fast_sac/T800WalkFlat/2026-08-24_19-24-54_mujoco/关键元数据来自该目录中的 run_config.json 和 run_summary.json:
| 项目 | 记录值 |
|---|---|
| 算法 | SAC(UniLab FastSAC) |
| 任务 | T800WalkFlat |
| 后端 | MuJoCo |
| seed | 1 |
| 并行环境 | 2,048 |
| 完成迭代 | 10,000 |
| 总环境步数 | 20,500,480(runner summary 原值) |
| 最终平均 reward | 296.6047 |
| 最佳平均 reward | 301.2552 |
| 最终平均 episode length | 1,878.39 |
| 训练 wall time | 310.60 s |
| 完整 run wall time | 339.10 s |
| 最终环境吞吐 | 60,641 env steps/s |
| 最终 learner 吞吐 | 1,940,515 samples/s |
| GPU(run 元数据) | NVIDIA GeForce RTX 4090,49,140 MiB |
| 系统内存(run 元数据) | 60.5 GB |
| 训练 commit | f270fe11250374ae873a8427e8fac7189eef3e97 |
| 训练分支 | feat/t800-walk-flat |
本机目前能找到的 T800 WalkFlat 记录可以这样归档:
| 记录 | 目录 | 结论 |
|---|---|---|
| SAC / MuJoCo | logs/fast_sac/T800WalkFlat/2026-08-24_19-24-54_mujoco | 完整训练:10,000 iterations,含 checkpoints、ONNX 和回放视频 |
| PPO / MuJoCo | logs/rsl_rl_ppo/T800WalkFlat/2026-08-26_14-35-52_mujoco | 启动 smoke test:只有 42 个 TensorBoard steps 和 model_0.pt,不作为完整结果 |
这里有一个容易踩坑的版本差异:当前 checkout 的 conf/sac/task/t800_walk_flat/mujoco.yaml 默认 algo.max_iterations 已经是 100000,而这条历史 run 的 run_config.json 明确记录的是 10000。因此下面的复现实验命令会显式写出 algo.max_iterations=10000;如果省略这个 override,就不是同一规模的实验。
2. 从零安装 UniLab 和 MuJoCo
我直接选用在平台上众擎机器人URKL大赛专用镜像,大大的减少了初级选手的工作量。 大赛推荐镜像地址:https://www.gpufree.cn/images/101312
2.1 新机器上的最短路径
UniLab 的仓库约定是通过 uv 管理环境,训练命令也统一走 uv run:
git clone https://github.com/unilabsim/UniLab.git
cd UniLab

# 只跑 MuJoCo 时使用这个较小的安装目标
make setup-mujocomake setup-mujoco 会执行 uv sync --extra mujoco,并安装 UniLab 的命令补全。如果系统没有 make,等价的基础步骤是:
uv sync --extra mujoco
uv run --no-sync unilab-complete installLinux 上如果 MuJoCo extra 需要编译原生扩展,还要准备编译器和 Python 开发头文件;仓库 README 给出的典型依赖是 build-essential 和 python3-dev。已有可用 .venv 的 checkout 不需要重复安装,直接从下一节开始即可。
2.2 确认 T800 资产没有缺失
T800 owner 在 materialize 环境前会解析二进制网格和纹理目录。最小检查可以直接执行:
cd /home/user/ws/UniLab

test -f src/unilab/assets/robots/t800/scene_flat.xml
test -f src/unilab/assets/robots/t800/t800.xml
test -f src/unilab/assets/robots/t800/assets/LINK_BASE.obj
test -f src/unilab/assets/robots/t800/textures/LINK_BASE.png
echo "T800 assets: OK"任务注册在 src/unilab/tasks/locomotion/t800/__init__.py:环境名是 T800WalkFlat,MuJoCo 和 mjwarp 都有 registry identity;本文只选择 MuJoCo owner。src/unilab/tasks/locomotion/t800/manager_terms.py 还定义了 T800 专用的关节位置 action 和足部横向间距 penalty。
3. UniLab 的任务路由:CLI 只负责选 owner
日常入口是顶层 CLI:
uv run train --algo sac --task t800_walk_flat --sim mujoco
        │
        └── conf/sac/task/t800_walk_flat/mujoco.yaml
                │
                └── /task/t800_walk_flat/base.yaml
                        │
└── T800WalkFlat registry → Manager-Based env → MuJoCo--sim mujoco 是后端 owner 的选择方式;不要把 training.sim_backend=mujoco 当成独立的后端切换开关。Hydra override 用来调整所选 owner 内部的参数,例如 algo.num_envs、algo.max_iterations 和 training.no_play。
在真正训练前,先只打印完整 compose 结果:
uv run train --algo sac --task t800_walk_flat --sim mujoco \
  algo.num_envs=2048 \
  algo.max_iterations=10000 \
  training.no_play=true \
--cfg job重点确认这些字段:
algo.num_envs: 2048
algo.max_iterations: 10000
algo.batch_size: 8192
env.sim_dt: 0.002
env.ctrl_dt: 0.01
training.task_name: T800WalkFlat
training.sim_backend: mujoco--cfg job 只输出配置,不会启动训练。它是排查“任务名、后端、算法和 override 是否真的生效”的最快一步。
4. WalkFlat 到底控制什么
4.1 25 个关节,不等于 25 维策略动作
T800 的 scene 配置列出 25 个关节/执行器(J00 到 J24)。但 WalkFlat 策略只输出 22 维动作:
| 类别 | 关节 | 数量 | 策略行为 |
|---|---|---|---|
| active actuator | 双腿和双臂的可控关节 | 22 | 由 SAC actor 输出目标位置 |
| held actuator | J12_TORSO_YAW、J23_HEAD_PITCH、J24_HEAD_YAW | 3 | 每步回到默认目标,不进入策略输出 |
| 合计 | T800 全部关节 | 25 | 22 维 action + 3 个 held 关节 |
这一点直接体现在 T800JointPositionAction:active 和 held selector 必须互斥且覆盖全部关节,held 目标在 action apply 时从默认关节位置和 encoder bias 解析。因而 checkpoint 里的 actor 输出形状是 (22,),不是 (25,)。
4.2 时间步和观测维度
配置使用:
sim_dt = 0.002 s;ctrl_dt = 0.01 s,也就是一个控制周期内推进 5 个 MuJoCo simulation step;max_episode_seconds = 20.0,理论上约为 2,000 个控制步。
实际 SAC actor/critic 的输入维度由环境 probe 和 checkpoint 形状共同确认:
| 网络 | 维度 | 主要内容 |
|---|---|---|
| actor policy observation | 77 | 基座角速度、投影重力、22 个相对关节位置、22 个相对关节速度、上一动作、速度指令、gait phase |
| critic observation | 80 | actor 观测对应的 critic group,额外包含 pelvis local linear velocity |
| action | 22 | active actuator 的 joint-position target |
可以从 checkpoint 再做一次不依赖环境的形状核对:
uv run --no-sync python - <<'PY'
import torch

ckpt = torch.load(
    "logs/fast_sac/T800WalkFlat/2026-08-24_19-24-54_mujoco/model_10000.pt",
    map_location="cpu",
    weights_only=False,
)
print("actor input:", tuple(ckpt["actor"]["net.0.weight"].shape))
print("actor output:", tuple(ckpt["actor"]["action_scale"].shape))
print("critic first layer:", tuple(ckpt["qnet"]["qnets.0.net.0.weight"].shape))
print("atoms:", tuple(ckpt["qnet"]["q_support"].shape))
PY这次记录应得到 actor input=(512, 77)、actor output=(22,)、critic 第一层输入 102 = 80 + 22,以及 101 个 distributional-Q atoms。
4.3 指令、终止和 reward
WalkFlat 是速度指令任务,twist 指令范围为:
| 分量 | 范围 |
|---|---|
lin_vel_x | [-0.6, 1.0] m/s |
lin_vel_y | [-0.4, 0.4] m/s |
ang_vel_z | [-0.8, 0.8] rad/s |
指令每 20 秒重采样;没有额外的 standing-environment 比例。终止条件包括超时、倾斜超过 65° 和根部高度低于 0.3 m。
reward 由速度跟踪、步态相位和存活奖励,以及姿态/动作/脚部约束组成:
| 项 | weight | 作用 |
|---|---|---|
tracking_lin_vel | +2.0 | 跟踪平面线速度 |
tracking_ang_vel | +1.5 | 跟踪偏航角速度 |
feet_phase | +5.0 | 鼓励与 gait phase 一致的摆腿 |
alive | +10.0 | 存活奖励 |
penalty_ang_vel_xy | -1.0 | 抑制横滚/俯仰角速度 |
penalty_orientation | -10.0 | 抑制姿态偏离 |
penalty_action_rate | -4.0 | 抑制动作抖动 |
pose | -0.5 | 关节姿态正则 |
penalty_feet_ori | -20.0 | 足部朝向约束 |
penalty_close_feet_lateral | -5.0 | 足部横向间距小于 0.18 m 时惩罚 |
这些项来自 conf/sac/task/t800_walk_flat/base.yaml;文章不把 reward 总分直接等同于真实机器人行走质量,最终仍要看回放和独立评测。
5. 先做一个小规模 smoke test
第一次在新环境上不建议直接占满 2,048 个环境。先用较小规模确认资产、MuJoCo native runtime、collector/learner IPC 和 checkpoint 写入都能工作:
cd /home/user/ws/UniLab
uv run train --algo sac --task t800_walk_flat --sim mujoco \
  algo.num_envs=128 \
  algo.max_iterations=10 \
training.no_play=true6. 正式训练:固定 2,048 env 和 10,000 iterations
6.1 复现实验命令
为了复现本文的历史规模,显式固定关键字段:
cd /home/user/ws/UniLab

uv run train --algo sac --task t800_walk_flat --sim mujoco \
  algo.num_envs=2048 \
  algo.max_iterations=10000 \
  algo.save_interval=1000 \
training.no_play=true这条命令适合服务器/无显示器环境。若希望像历史 run 一样在训练后自动生成回放视频和 policy.onnx,把最后一行改为 training.no_play=false;也可以训练完后单独执行 uv run eval,这样训练和评估日志更容易分开管理。
6.2 这组 SAC 参数的含义
正式 run 的关键算法参数如下:
| 参数 | 值 |
|---|---|
num_envs | 2048 |
batch_size | 8192 |
replay_buffer_n | 512(每个环境的 ring 深度) |
updates_per_step | 8 |
learning_starts | 10 |
policy_frequency | 4 |
gamma | 0.98488578 |
tau | 0.125 |
| actor / critic learning rate | 3e-4 / 3e-4 |
| actor hidden width | 512(后续层为 256, 128) |
| critic hidden width | 768(后续层为 384, 192) |
alpha_init | 0.001 |
| AMP / compile | 开启 |
UniLab 的 FastSAC 使用 device-resident replay:完整 replay ring 在 learner device 上,collector 只通过固定深度的共享 ingress slot 送入新 transition。这样 /dev/shm 不需要承载整个 replay ring,但 GPU 会承担 ring 和 batch staging 的显存。
6.3 训练过程中看什么
另开终端启动 TensorBoard:
cd /home/user/ws/UniLab
uv run tensorboard \
  --logdir logs/fast_sac/T800WalkFlat/2026-08-24_19-24-54_mujoco \
--port 6006主曲线建议同时看:
reward/mean:当前 logging 点的平均 reward;reward/mean_ep100:更平滑的 episode-100 reward;episode/length:是否逐渐接近 20 秒 horizon;perf/steps_per_sec和perf/effective_samples_per_sec:吞吐是否在编译 warm-up 后稳定;reward/*:确认 reward 上升来自速度跟踪/步态,而不是某个惩罚项异常消失;train/qf_loss、train/actor_loss、train/alpha、train/action_std:排查 learner 是否数值发散。
7. 实验结果:训练确实跑完了什么程度
7.1 训练后回放帧
历史 run 自动生成了 8 秒、1280×720、100 fps 的 play_video.mp4。下面是第 4 秒的一帧;画面中的多个 T800 是 play_env_num=16 的并行回放环境,适合作为 sanity check,不是单独的定量评测:
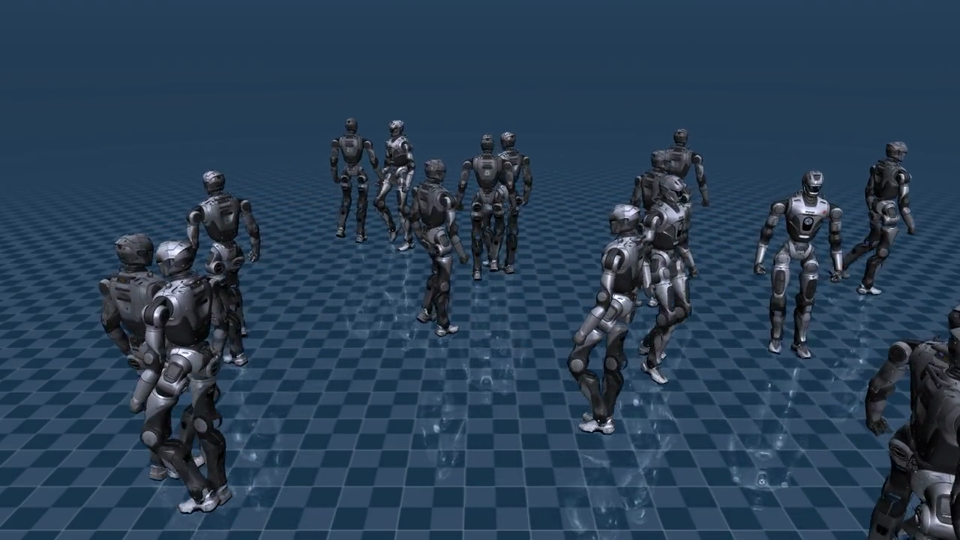
完整视频:T800play_video.mp4。
7.2 平均 reward 曲线
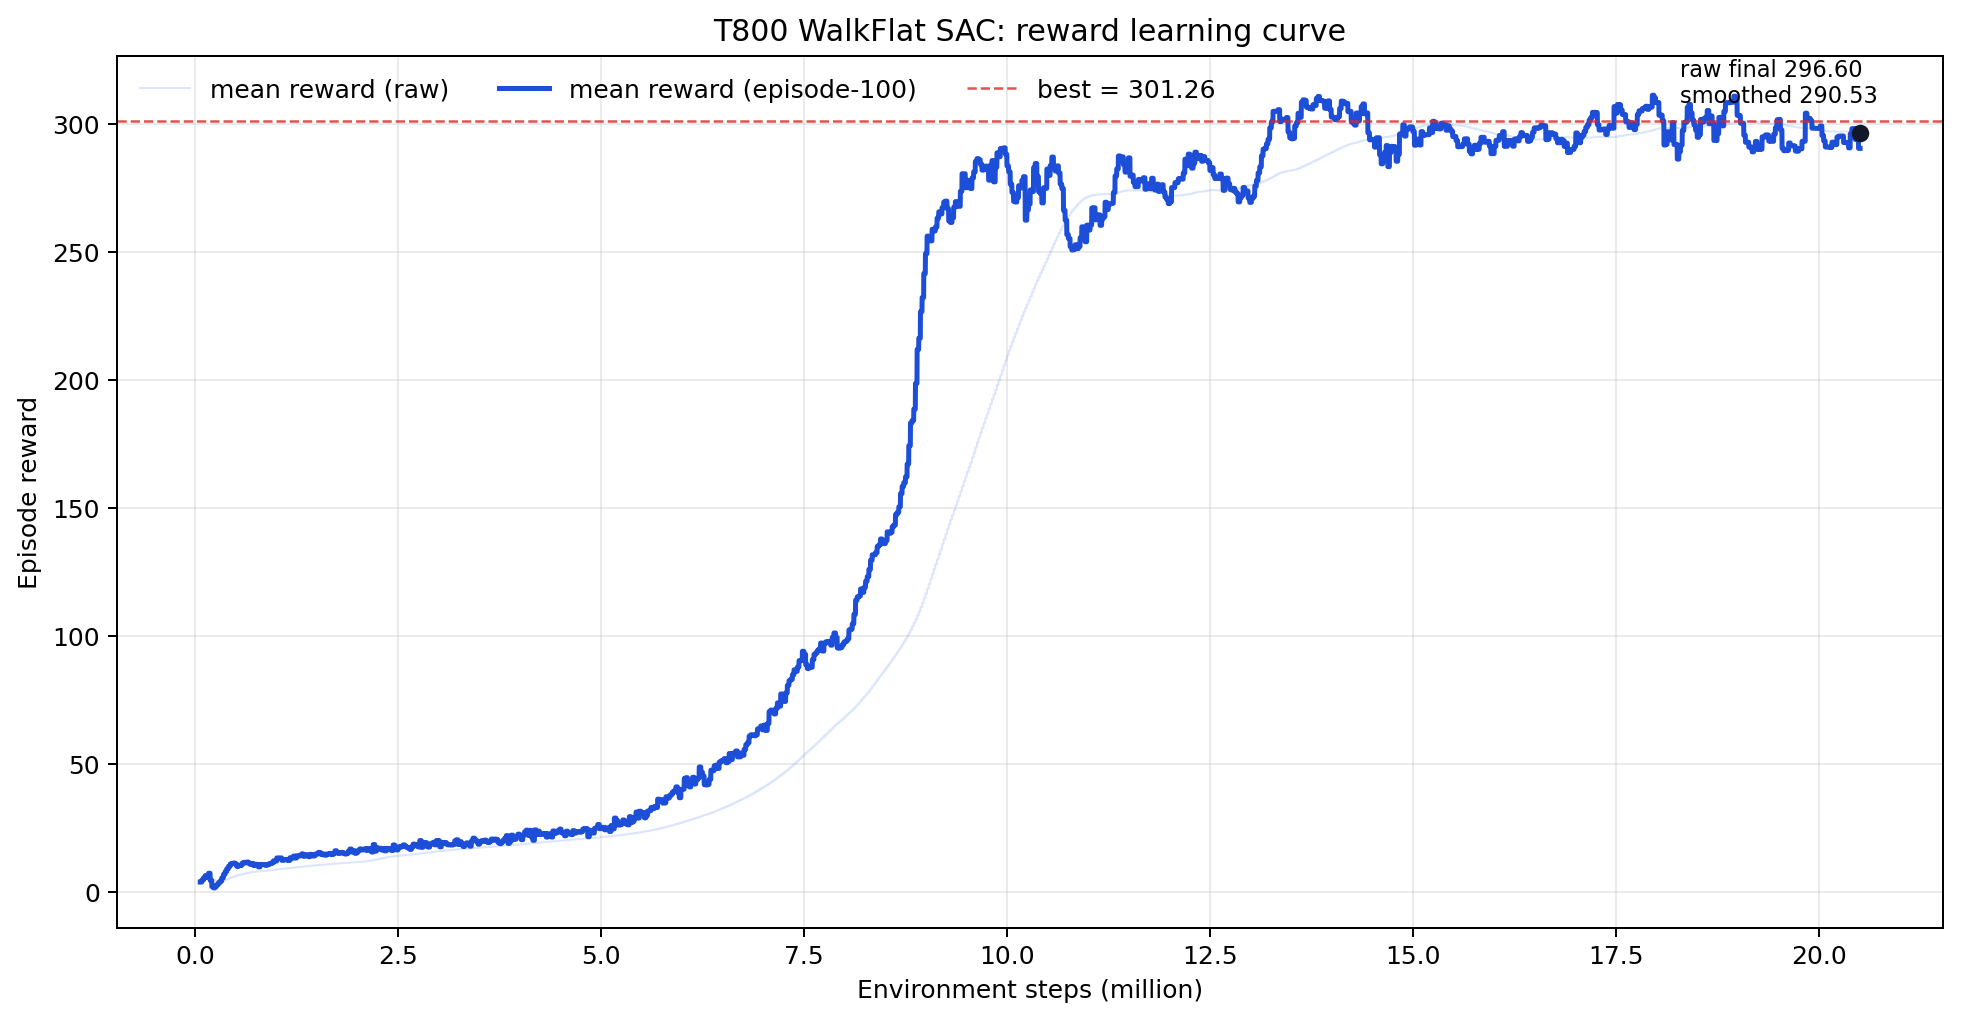
图中的浅蓝线是 reward/mean 原始点,深蓝线是日志提供的 reward/mean_ep100,红色虚线标出 run summary 中的最佳平均 reward 301.26。注意最后一个原始点是 296.60,平滑曲线最后一点约为 290.53;两者不是同一个统计量。
7.3 episode length 与吞吐
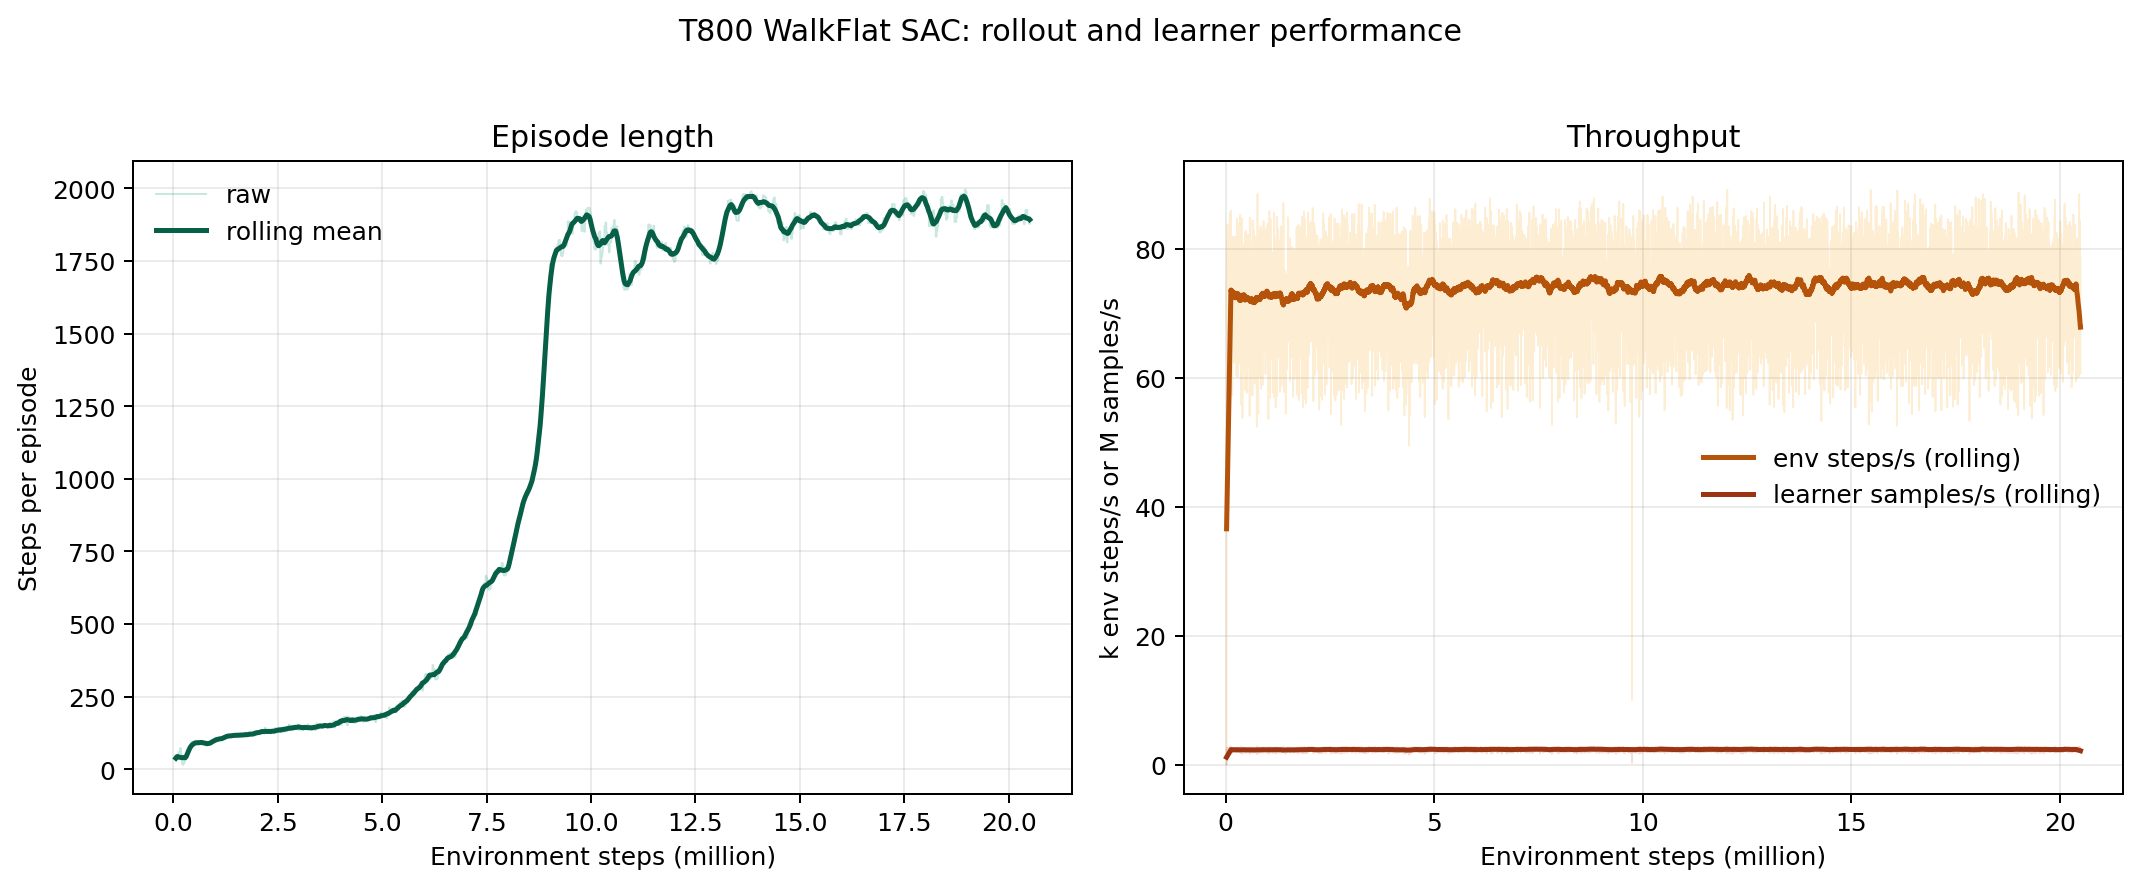
episode length 从早期的几十步逐渐提升到约 1,878 步。由于 ctrl_dt=0.01 s、episode 上限为 20 秒,这意味着后期很多 episode 已经接近时间上限。吞吐图同时画出环境 steps/s(千步/秒)和 learner samples/s(百万样本/秒),两者的单位不同,不能直接相加。
7.4 reward 组成
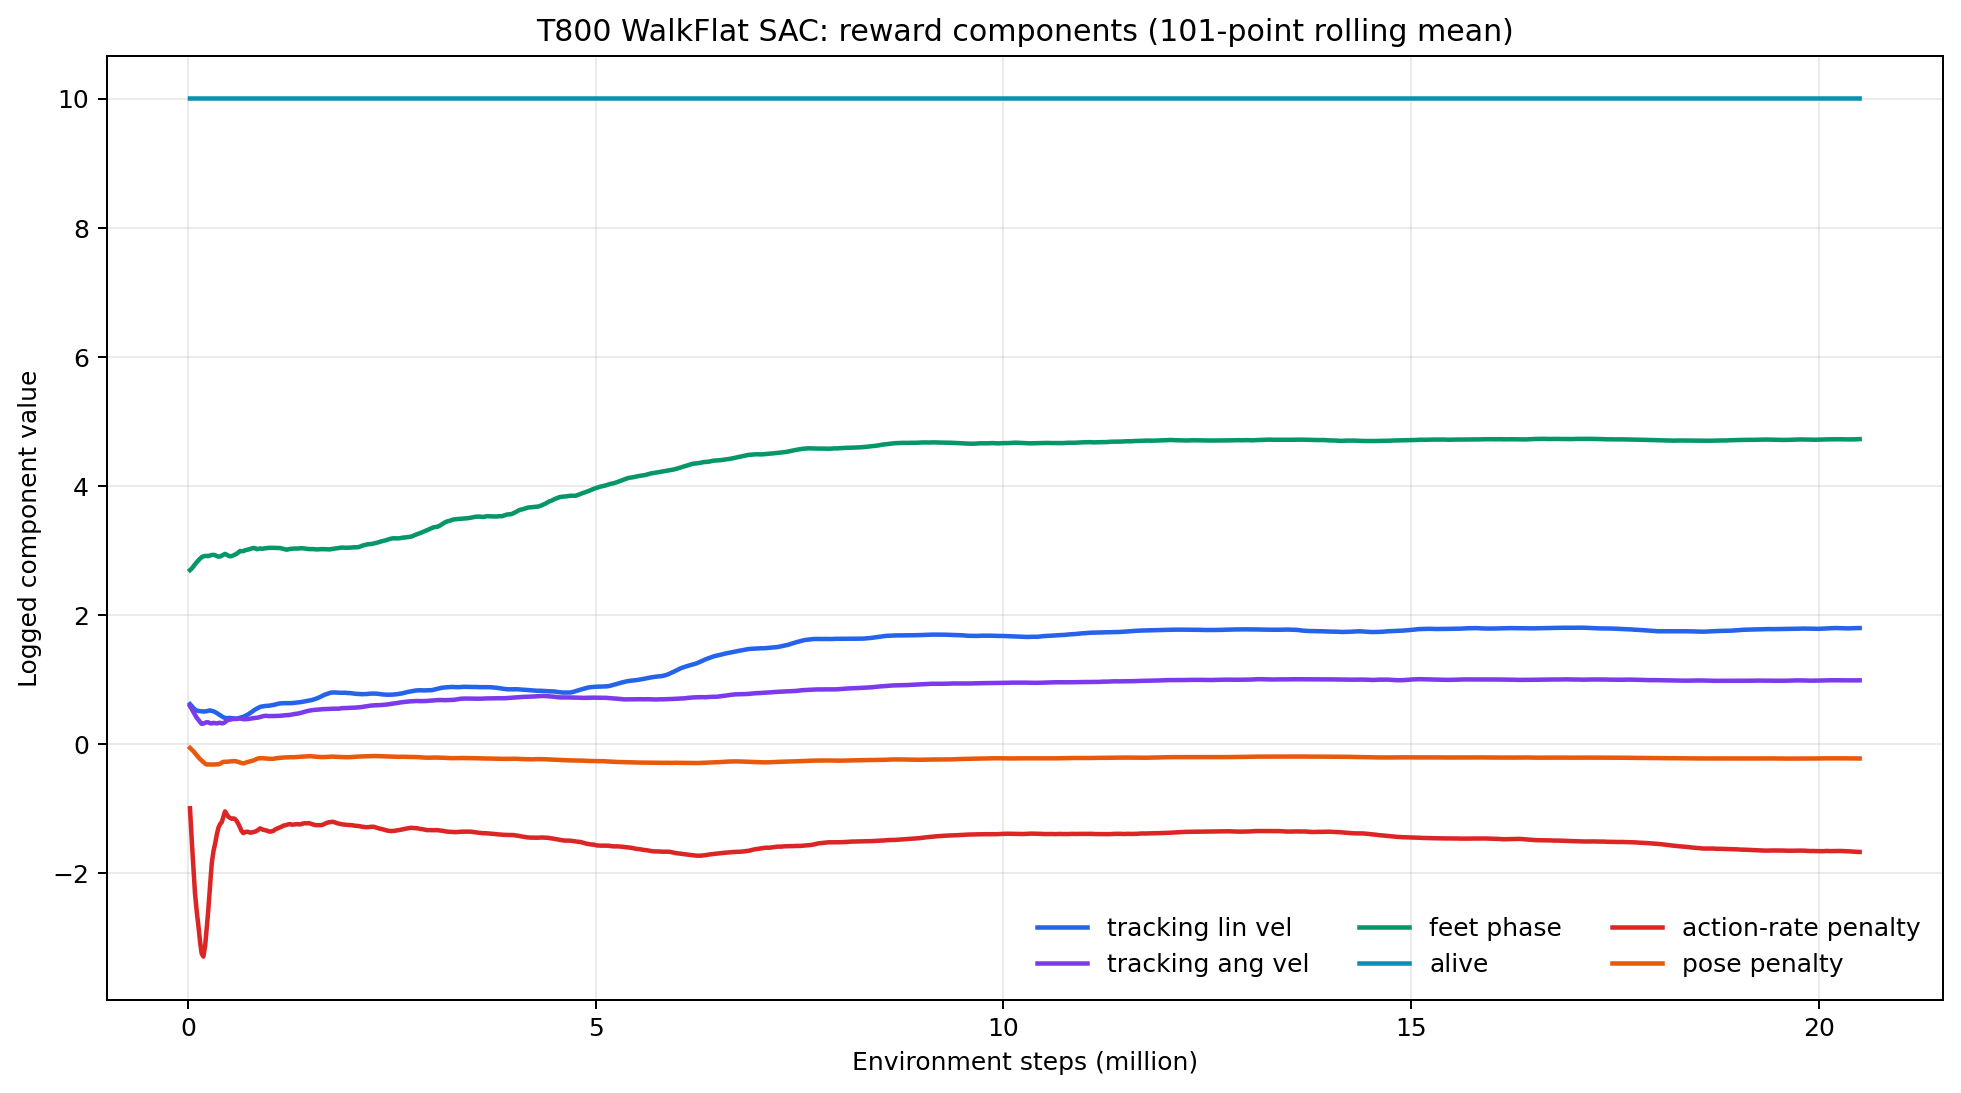
图中使用 101 个 logging 点的 rolling mean 只为了可读性,原始 scalar 没有被修改。训练后 tracking_lin_vel 约 1.80、tracking_ang_vel 约 0.99、feet_phase 约 4.73,alive 保持 10.0;动作速率和 pose 惩罚在后期维持更负的水平。这比只看总 reward 更容易发现“总分上升但某个约束失效”的情况。
7.5 SAC learner 诊断
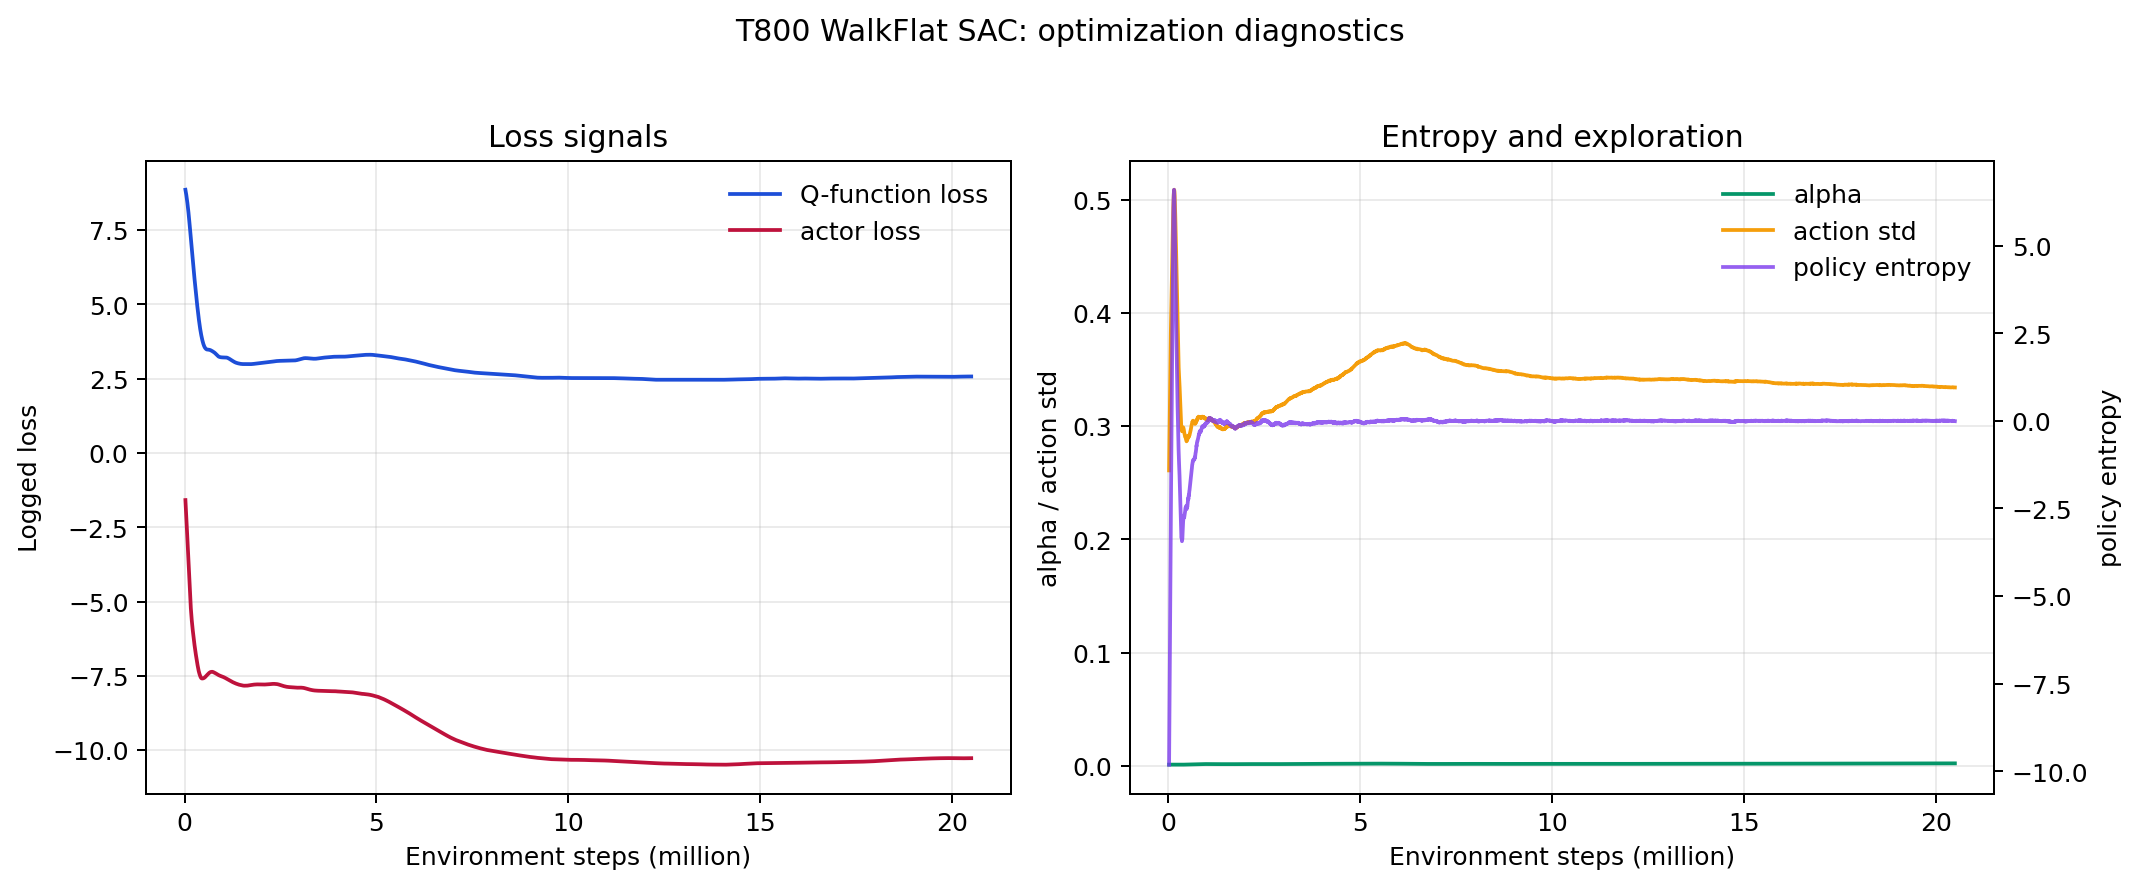
Q-function loss 从 warm-up 初期的较高值下降并稳定在约 2.6 附近;actor loss、alpha、action standard deviation 和 policy entropy 没有出现持续发散。这里的曲线用于诊断训练过程,不代表已经完成 sim-to-real 验证。
7.6 几个可复核的里程碑
下表从同一个 TensorBoard event 文件取最近 logging 点,横轴统一用 environment steps:
| environment steps(约) | 平均 reward | episode length |
|---|---|---|
0.063 M(首个 reward 点) | 3.72 | 30.00 |
2.048 M | 11.64 | 131.03 |
10.240 M | 228.16 | 1,741.45 |
15.360 M | 299.87 | 1,915.59 |
20.500 M(最后一个点) | 296.60 | 1,878.39 |
reward 的主要跃升发生在约 8–10M steps;之后在 290–301 区间波动。单个 seed、单个 run 不足以给出统计显著性结论,但足以证明这组 T800 WalkFlat owner 和 2,048-env FastSAC 路径在本机完成过一次端到端训练。
8. 如何验收“训练完成”
不要只看终端最后一行;以 run_summary.json 为准:
cd /home/user/ws/UniLab

jq '{status, completed_iterations, total_env_steps,
    final_mean_reward, best_mean_reward, mean_episode_length,
    training_wall_time_sec, final_env_steps_per_sec,
    final_learner_samples_per_sec, last_checkpoint}' \
  logs/fast_sac/T800WalkFlat/2026-08-24_19-24-54_mujoco/run_summary.json

find logs/fast_sac/T800WalkFlat/2026-08-24_19-24-54_mujoco \
-maxdepth 1 -type f -printf '%f\n' | sort验收清单:
status是completed;completed_iterations是10000;last_checkpoint指向model_10000.pt;model_1000.pt到model_10000.pt按 1000 间隔存在;- 若需要部署/回放导出,
policy.onnx应存在且非空(历史 run 已生成;training.no_play=true的纯训练命令可在之后用uv run eval导出); - 若没有设置
training.no_play=true,还应有play_video.mp4; run_config.json记录了 seed、硬件、git commit 和完整 Hydra 配置。
9. 常见故障和判断顺序
训练过程中遇到问题时,可以按下面的顺序排查:先确认任务和资产,再确认 GPU,最后再调整并行规模。
任务或资产找不到
先运行资产检查,再运行任务配置检查。不要一开始就把问题归因于 SAC;T800 环境需要在启动时找到对应的网格和纹理文件。
CUDA 不可见
同时检查显卡工具和 PyTorch:
nvidia-smi
uv run --no-sync python - <<'PY'
import torch
print(torch.cuda.is_available(), torch.cuda.device_count())
PY如果系统能看到显卡而 PyTorch 看不到,先修复驱动或运行环境,再开始训练。
显存不足(OOM)
先确认没有其他程序占用显卡,再把并行环境数从 2048 降到 1024,保留一份新的日志。调整一次只改一个关键参数,便于判断问题是否解决。
无显示器环境卡在回放
训练时设置 training.no_play=true,或评估时使用无渲染模式。训练已经完成与回放渲染失败是两个不同阶段,应分别记录。
10. 局限与下一步
这篇记录证明的是一次本机端到端训练路径,而不是完整的机器人验收:
- 只有一个 seed(
1),没有多 seed 均值和方差; - reward 变好不等于真实机器人一定能安全行走;
- 没有在真实 T800 硬件上做 sim-to-real 安全验证。
如果下一步继续优化,建议先做独立回放和多次评测,再决定是否扩大训练规模或改进算法。单次实验可以说明流程跑通,但不能替代多次实验和真实硬件测试。