
主题
精通大语言模型技术:推理优化 大模型推理
精通大语言模型技术:推理优化
注:来源于NVIDIA Technical Blog
摘要:
- 大语言模型(LLM)推理阶段对内存与算力消耗巨大;检索增强生成(RAG)等场景处理长输入 / 长上下文会带来高昂成本。
- LLM 推理分为两个阶段:预填充阶段以高度并行方式处理输入 Token;解码阶段自回归逐个生成输出 Token,GPU 算力利用率较低。
- 键‑值缓存(KV 缓存)是解码阶段的主流优化手段,缓存中间状态避免重复计算,但在大批次、长序列场景下会引发内存压力。
- 模型并行技术,包括流水线并行、张量并行、序列并行,可以降低单卡内存占用,支持更大模型或者更大批处理规模。
- 注意力机制优化:多查询注意力(MQA)、分组查询注意力(GQA)降低 KV 缓存内存开销;FlashAttention 通过减少内存搬运提升性能。
- 基于分页注意力(PagedAttention)高效管理 KV 缓存,大幅减少内存浪费,支持更大批处理规模、提升吞吐。
堆叠 Transformer 层得到的大模型拥有更高精度、少样本学习能力,甚至在各类语言任务上具备接近人类的涌现能力。这类基座模型训练成本高昂,推理阶段同样会持续消耗大量内存与算力。如今主流大语言模型参数量可达数百亿级别;部分业务场景还需要处理超长输入(上下文),进一步推高推理成本。例如检索增强生成(RAG)流水线需要向模型输入海量外部信息,显著增加大模型的计算负担。
本文将讲解大语言模型推理面临的核心挑战与实用解决方案。阅读本文需要你了解 Transformer 架构与注意力机制的基础知识。
开发者可以基于开源的 NVIDIA 模型(如 Nemotron‑3 系列),在开源库TensorRT‑LLM中实操这些推理优化技术。该项目托管于 GitHub,你可以使用生产级代码开展实验,而不是只停留在抽象示例层面。
理解大模型推理
主流仅解码器架构的大语言模型(例如 GPT‑3)以因果建模为预训练目标,本质上就是一个下一词预测器。模型接收一串 Token 作为输入,以自回归方式不断生成后续 Token,直到触发停止条件(达到最大生成 Token 数、命中停止词)或者输出代表结束的特殊<end>标记。整个推理分为 ** 预填充(prefill)与解码(decode)** 两大阶段。
注:Token 是模型处理语言的最小单元。1 个 Token 大约对应 4 个英文字符。所有自然语言输入在送入模型前都会转换为 Token。
预填充阶段:处理输入
预填充阶段,大模型处理全部输入 Token,计算得到中间状态(Key 与 Value),用于生成第一个新 Token。虽然每个新 Token 依赖全部历史 Token,但输入内容是完整已知的,该阶段本质是矩阵‑矩阵运算,计算高度并行,可以充分打满 GPU 算力。
解码阶段:生成输出
解码阶段模型自回归逐一生成输出 Token,直到触发停止条件。每一步生成的 Token,都需要前面所有轮次输出的 Key、Value 状态。该阶段属于矩阵‑向量运算,相比预填充,GPU 算力无法充分利用。
延迟的瓶颈不再是计算速度,而是数据(权重、Key、Value、激活值)从内存向 GPU 的传输速度,也就是典型的内存带宽受限场景。本文介绍的大部分推理优化方案,都是针对解码阶段:优化注意力模块、高效管理 KV 缓存等。
不同大模型使用的分词器不同,直接对比每秒输出 Token 数并不公平。即便两个模型每秒生成 Token 数量相同,如果分词器不一样,实际输出字符数也会存在差异。
批处理(Batching)
提升 GPU 利用率与吞吐最直接的手段就是批处理。多个请求共享同一套模型权重,权重的内存开销被分摊;大批量请求送入 GPU 同时处理,可以充分利用硬件算力。
但批大小不能无限制增大,超过阈值后会触发内存溢出。想要理解背后原因,就需要了解 KV 缓存以及大模型的内存占用构成。
传统批处理也叫静态批处理,存在明显缺陷:同一个批次内各个请求生成的 Token 长度各不相同,执行时间长短不一。整个批次必须等待执行最慢的请求完成才能结束。生成长度差异越大,资源浪费越严重。** 飞行批处理(in‑flight batching)** 可以缓解该问题。
例如 NVIDIA 开源运行时 TensorRT‑LLM 就为 Llama、Nemotron 等主流开源模型实现飞行批处理与调度优化,开发者无需手写调度逻辑、编写 CUDA 内核。
键‑值缓存(KV 缓存)
KV 缓存是解码阶段非常经典的优化。解码阶段每一步只生成 1 个 Token,但该 Token 依赖全部历史 Token 的 Key、Value 张量,既包含预填充阶段算出的输入 KV,也包含解码过程中新生成的 KV。
如果每一步都重新计算全部历史 KV 张量,开销极大。KV 缓存的思路就是把这些张量保存在 GPU 显存,每一轮计算出新的 KV 后追加到缓存,直接供下一轮使用。很多实现中 Transformer 每一层都维护独立的 KV 缓存。
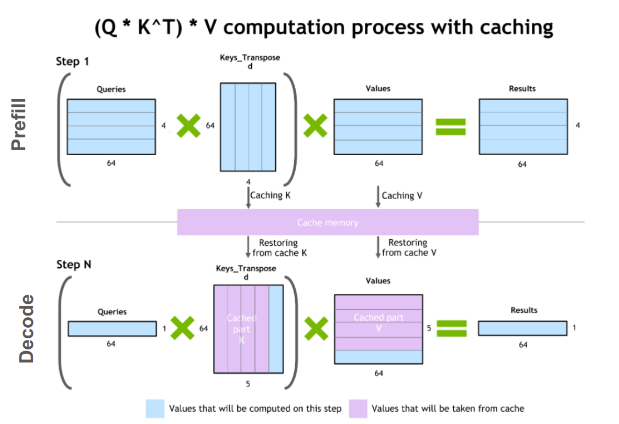
图 1:KV 缓存机制示意图
大模型内存占用
大模型在 GPU 上的内存占用主要来自两部分:模型权重、KV 缓存。
- 模型权重:存放模型参数。举个例子,Llama2‑7B 以 16 位精度(FP16/BF16)加载,内存占用约
70亿 × 2字节 ≈ 14GB。 - KV 缓存:缓存自注意力张量,避免重复计算。
开启批处理时,批次中每个请求都需要独立分配 KV 缓存,整体内存开销会变得很大。下面是通用的 KV 缓存单 Token 内存计算公式:
单个 Token 的 KV 缓存字节数 =
2 × 层数 × (头数 × 头维度) × 单元素字节数
系数 2 代表 Key、Value 两份矩阵。通常头数 × 头维度等价于 Transformer 的隐藏维度d_model,该参数可以在模型配置文件中查询。
该开销作用于批次内序列的每一个 Token。半精度下 KV 缓存总大小公式:
KV 缓存总字节数 =
批大小 × 序列长度 × 2 × 层数 × 隐藏维度 × FP16单元素字节(2)
示例:Llama2‑7B,16 位精度,批大小 = 1 时,KV 缓存占用:
1 × 4096 × 2 × 32 × 4096 × 2 ≈ 2GB。
高效管理 KV 缓存是一大难点。KV 缓存内存随批大小、序列长度线性增长,快速耗尽显存,限制服务吞吐,长上下文场景尤为棘手,下文多项优化就是为了解决该痛点。
通过模型并行扩展大模型规模
降低单卡权重内存占用的方案之一:把模型拆分部署到多张 GPU 上。将内存、计算压力分散,就可以运行更大模型、支持更大批处理。当单个 GPU 显存不足以放下完整模型,就必须使用模型并行,把延迟、吞吐控制到业务可用范围。依据权重拆分方式不同,分为多种并行方案。
补充:数据并行常和模型并行一起被提及。数据并行是将完整模型复制到多张显卡,输入全局批次切分为多个微批次分发到各个卡处理,提升总吞吐。但这是训练阶段优化,推理场景用处有限。
Megatron‑LM、NeMo 等开源框架都内置流水线并行、张量并行等模型并行能力,支撑各类开源模型训练和推理工作流。
流水线并行(Pipeline parallelism)
流水线并行属于纵向切分:将完整模型按层切分成若干块,每一块部署在独立 GPU 上。例如四路流水线并行,就是把全部层均分为四组,每组在一张显卡执行。一张卡的运算输出传递到下一张卡继续执行后续层。每张卡只保存部分层的权重,权重内存占用理论上降低到原来 1/4。
该方案主要短板是串行执行带来的设备空闲:等待上一层输出(激活、梯度)时,部分 GPU 会处于空闲,产生所谓流水线气泡,前向、反向传播都会出现资源浪费。
微批处理可以缓解气泡:把全局大批次切分成多个更小的微批次依次处理,最后累加梯度。微批处理可以缩小气泡,但无法完全消除。
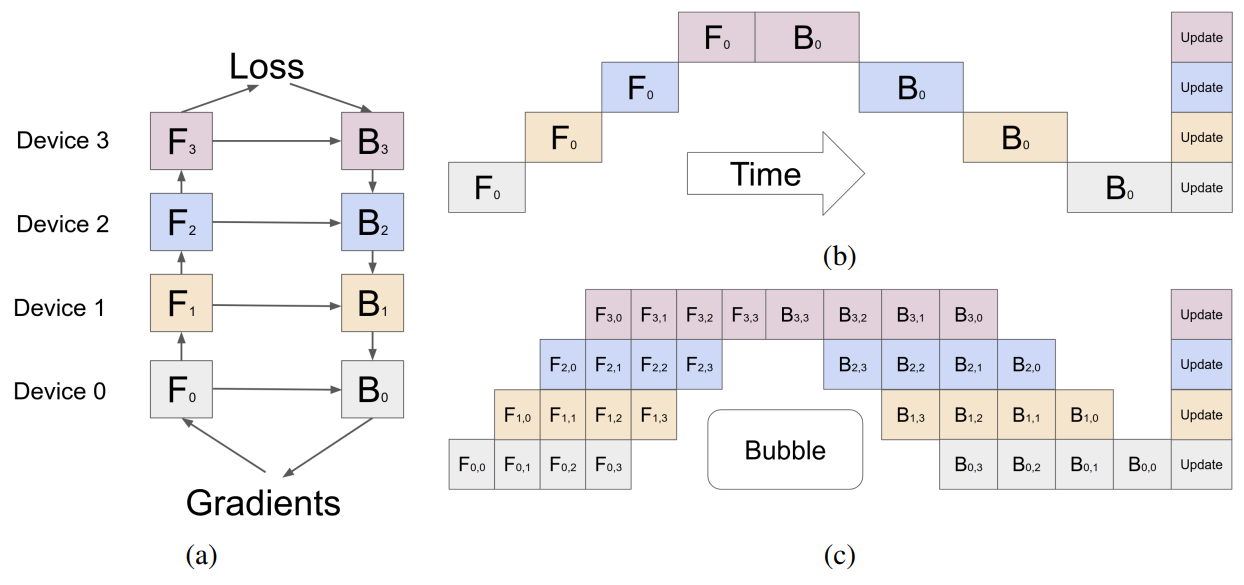
图2。四路流水线并行性示例。图片来源:GPipe:微批处理流水线并行的简易扩展
张量并行(Tensor parallelism)
张量并行是对单层内部做横向切分,将层内计算拆分为独立子任务分发到多张 GPU。Transformer 的注意力模块、MLP 多层感知机层都可以做张量并行。多头注意力中,可以把不同注意力头分配给不同 GPU,实现并行计算。
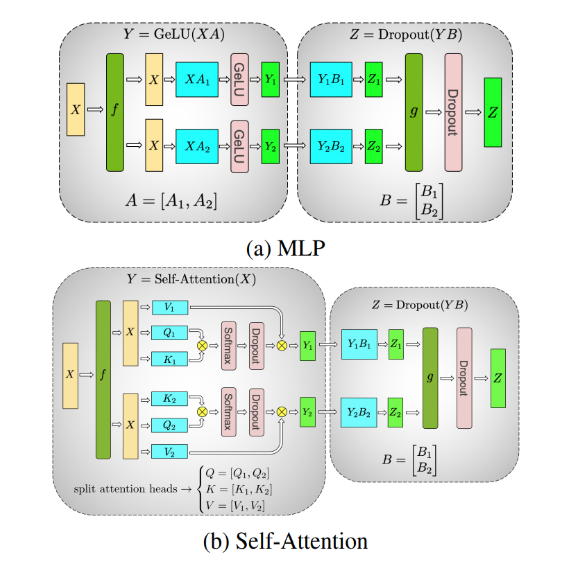
图 3:MLP 层与自注意力层的张量并行示意图,引用自《Megatron‑LM: Training Multi‑Billion Parameter Language Models Using Model Parallelism》
以两层 MLP 的两路张量并行举例:第一层权重矩阵 A 拆分为 A₁、A₂;输入 X 分别和 A₁、A₂在两张显卡独立计算;第二层通过归约操作 g 合并两张卡输出结果。单卡权重内存占用减半。自注意力层则天然可以将不同头拆分到多卡并行。
序列并行(Sequence parallelism)
张量并行有局限:LayerNorm、Dropout 这类算子无法拆分成独立子块,会在所有张量并行 GPU 上完整复制一份。虽然这两个算子计算量不大,但冗余保存激活值会消耗大量显存。
相关论文提出:LayerNorm、Dropout 可以沿着序列维度切分计算,不同序列分片交给不同 GPU,降低激活值内存开销,该技术就是序列并行。
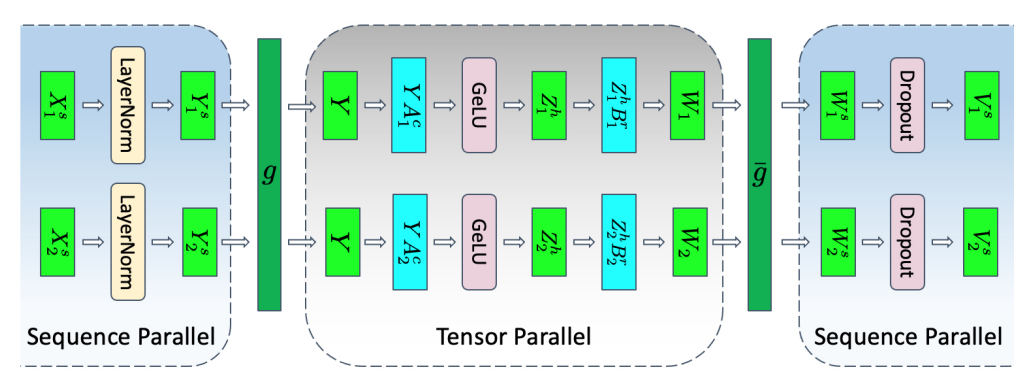
图 4:同时使用张量并行 + 序列并行的 Transformer 层示意图,引用自《Reducing Activation Recomputation in Large Transformer Models》
各类模型并行技术可以组合使用,共同降低单卡显存压力。除了模型并行,注意力模块本身也有很多优化手段。
注意力机制优化
缩放点积注意力(SDPA)将 Query、Key‑Value 映射得到输出,出自论文《Attention Is All You Need》。
多头注意力 MHA
多头注意力是 SDPA 的增强版本:并行执行多套注意力,每套对 Q/K/V 做独立可学习投影,让模型同时从多个特征子空间学习输入不同位置的关联关系。各个头输出拼接后再做一次线性投影融合结果。每个头维度通常为总模型维度除以头数量,例如 8 头时每个头维度d_model/8,整体计算量和单头注意力接近。
多查询注意力 MQA
MQA 是针对 MHA 的推理优化,出自论文《Fast Transformer Decoding》:多个查询头共享同一组 Key、Value 头,Query 仍然做多路投影。
MQA 总计算量和 MHA 持平,但内存读取的 KV 数据大幅减少。当性能瓶颈是内存带宽时,可以显著提升硬件利用率,同时压缩 KV 缓存体积,支持更大批大小。
代价是模型精度存在下降风险。想要使用 MQA,模型训练阶段(或使用约 5% 训练数据做微调)就必须开启 MQA。
分组查询注意力 GQA
GQA 在 MHA 和 MQA 之间做折中:Key‑Value 被分成少数几个组,每个组内的多个 Query 头共享这一组 KV,组内行为等价 MQA。
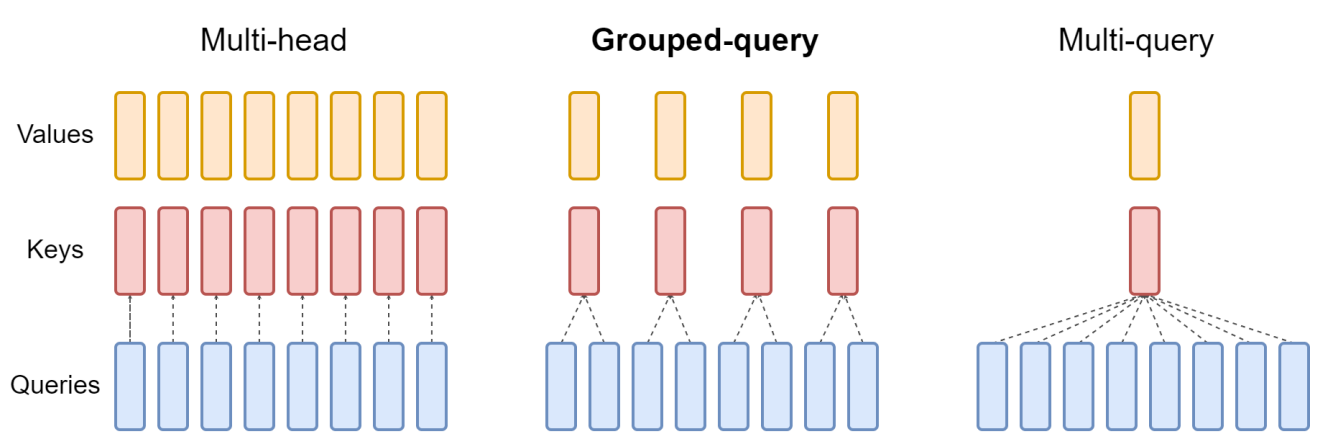
图 6:不同注意力机制对比,引用自《GQA: Training Generalized Multi‑Query Transformer Models from Multi‑Head Checkpoints》
左:MHA,KV 头数量等于 Query 头;中:GQA,KV 头数少于 Query 头、大于 1,兼顾内存开销与模型效果;右:MQA,全局仅一组 KV 头,最大化节省内存。
原本基于 MHA 训练的模型,可以使用少量算力做 “升级训练” 转为 GQA,效果接近原生 MHA,同时保有 MQA 的计算效率。Llama2‑70B 就是使用 GQA 的典型代表。
MQA/GQA 通过减少 KV 头数量降低 KV 缓存内存,但 KV 缓存本身的内存管理依然会存在浪费,下面介绍 PagedAttention。
FlashAttention
FlashAttention 从计算执行顺序入手,充分利用 GPU 的内存分层架构。传统实现按层顺序执行运算,已经加载到高速显存的数据会反复读写回低速显存,效率不高。运算融合可以减少 GPU 读写显存次数,把用到同一份数据的计算合并,即便这些计算分属网络不同层。
FlashAttention 是非常知名的 IO 感知精确注意力算法,出自论文《FlashAttention: Fast and Memory‑Efficient Exact Attention with IO‑Awareness》。
- 精确注意力:数学等价于标准多头注意力(也支持 MQA/GQA 变体),可以直接替换现有模型,不需要修改权重。
- IO 感知:运算融合时充分考虑内存搬运开销。它使用分块(tiling)策略,小块完成全部计算后再写回显存,而不是对完整大矩阵分步计算、反复落盘中间结果。
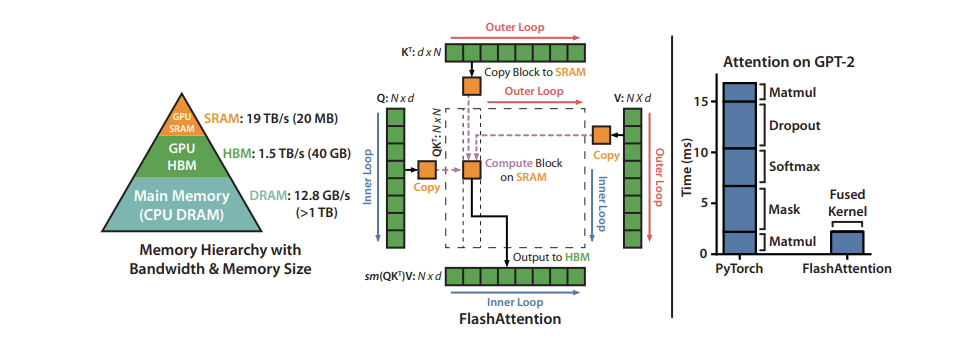
图 7:FlashAttention 分块计算模式与 40GB GPU 内存层级示意图,右侧展示运算融合重排带来的加速比,引用自《FlashAttention: Fast and Memory‑Efficient Exact Attention with IO‑Awareness》
基于分页实现高效 KV 缓存管理
很多场景下,由于输入长度不可预知,KV 缓存会做静态超配:按照模型支持最大序列长度预留连续显存。例如最大支持 2048Token,无论实际输入输出多长,都直接预留 2048 大小的连续内存块。该内存块在请求的整个生命周期被占用,但大部分空间可能根本不会被使用,造成内存浪费、内存碎片。
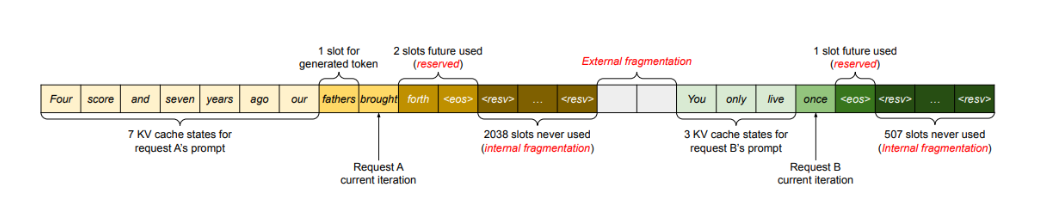
图 8:KV 缓存静态超配带来内存浪费与碎片示意图,引用自《Efficient Memory Management for Large Language Model Serving with PagedAttention》
借鉴操作系统虚拟内存分页思想,PagedAttention(分页注意力) 允许把连续逻辑上的 KV,存放到物理上不连续的显存块。每个请求的 KV 缓存被切分为固定 Token 数的内存块;通过块表记录逻辑位置与物理块映射关系,计算注意力时按需读取块。生成新 Token 就分配新物理块。块大小固定,消除不同请求分配大小不一带来的低效。极大减少内存浪费,支持更大批处理,提升整体吞吐。
模型本身的优化技术
前面介绍了内存如何在多张 GPU 之间分布、注意力模块优化、KV 缓存管理。还有一类优化直接修改模型权重,降低单卡内存占用。GPU 硬件还有专门指令集加速这些优化后的数值运算,进一步提速。
量化(Quantization)
量化降低权重、激活值的数值精度。模型训练通常使用 32 位或者 16 位浮点数。实践证明很多大模型可以用 8bit 甚至更低比特有效表达。
精度降低带来多重收益:相同硬件可以加载更大模型;带宽受限场景下,单位时间可以传输更多参数,加速推理。
大模型量化分为权重量化、激活量化,也可以两者同时量化。
- 权重量化:权重训练完成就固定,实现简单。但激活仍然保持高位宽。硬件没有 INT8 与 FP16 直接相乘的加速单元,计算时权重需要转回高位宽,性能无法拉满。
- 激活量化:对 Transformer 层输入做量化。难点在于激活经常存在异常离群值,动态范围波动大,很难低比特稳定表示。
解决方案举例:使用代表性数据集跑模型,定位离群激活位置,部分张量保留高位宽(LLM.int8 ());或者复用权重的动态范围用于激活量化。
稀疏化(Sparsity)
大量深度学习模型对剪枝具备鲁棒性:把接近 0 的参数置为 0,得到稀疏矩阵。稀疏矩阵使用压缩格式存储,体积小于稠密矩阵。
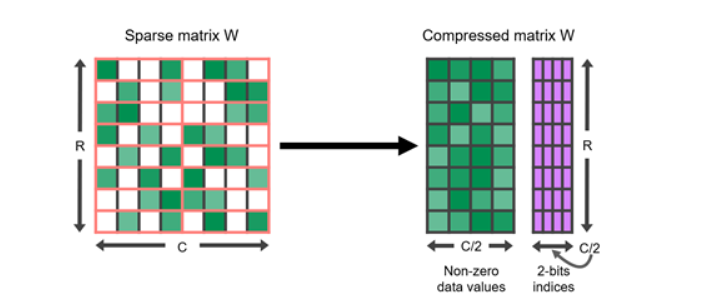
图 10:稀疏矩阵压缩存储,仅保存非零数值与索引
GPU 硬件支持结构化稀疏(每 4 个值中 2 个置零)的加速。稀疏表示还可以和量化叠加获得更高加速。如何得到效果最优的稀疏大模型仍然是活跃研究方向,是未来推理提速的重要路径。
知识蒸馏(Distillation)
蒸馏把大模型(教师模型)的知识迁移到更小的学生模型。训练学生模型模仿教师输出行为。经典例子 DistilBERT,模型体积压缩 40%,语言理解能力保留 97%,推理速度提升 60%。
大模型蒸馏仍在快速演进,基础思路出自论文《Distilling the Knowledge in a Neural Network》:
- 训练学生网络拟合教师模型输出,损失函数衡量两者输出差异;也可以同时使用原始标签损失。
- 学生可以拟合教师最后一层输出 Logits,也可以拟合中间层激活。
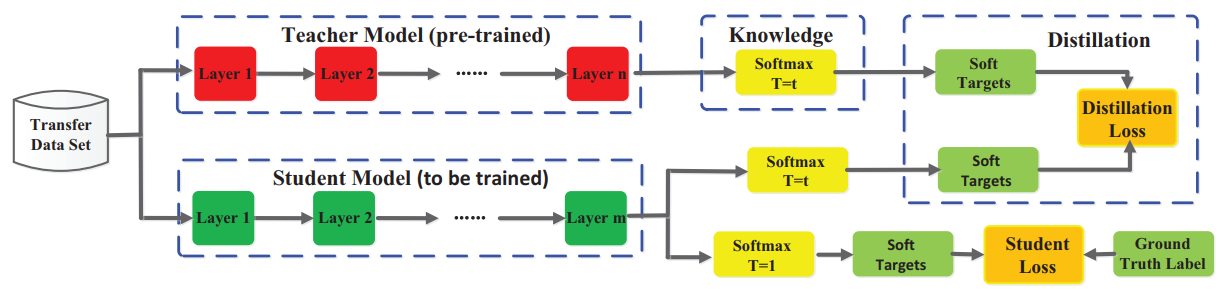
图 11:知识蒸馏通用框架示意图,引用自《Knowledge Distillation: A Survey》
还有一类方案:教师生成合成数据,用于监督训练学生模型,适合缺少人工标注的场景。论文《Distilling Step by Step!》更进一步,不仅输出标签,还提取教师推理中间步骤,高效训练小模型。
⚠️注意:很多主流大模型许可协议禁止使用其输出来训练其他模型,寻找可用教师模型会遇到限制。
模型服务技术
大模型推理经常受限于内存带宽,尤其是权重读取带宽。即便完成前面所有模型优化,仍然大概率处于带宽瓶颈。因此要尽可能在权重加载进显存之后做多件事,核心思路就是并行,两大主流技术:飞行批处理、推测解码。
飞行批处理(In‑flight batching)
大模型服务负载高度动态:问答、文档摘要、代码生成,不同请求输出长度差异巨大。普通批处理很难高效调度,会出现部分请求早早结束、部分还在长时间运行。
飞行批处理(连续批处理)专门应对动态负载:利用生成是一轮一轮迭代执行这一特性。不需要等待整批全部结束再处理新请求;一旦某个序列生成完毕,立刻将它移出批次,同时加入新请求,其他还在执行的请求不受干扰。大幅提升真实业务场景 GPU 利用率。
推测推理(Speculative inference)
也叫推测采样、辅助生成、分块并行解码。原生 GPT 类模型严格自回归,生成第 n 个 Token 之后,才能生成 n+1,同一个序列无法并行多步解码。推测推理给出绕开限制的思路。
流程:
- 使用低成本方式(小草稿模型等)生成一串候选 Token 草稿;
- 把草稿送入主验证模型,并行批量验证多步;
- 如果草稿 Token 和主模型输出一致,直接采纳;遇到第一个不匹配,丢弃后面全部候选,重新生成草稿继续推理。
生成草稿的方案有多种,各有利弊:训练专门做多步预测的网络;或者用一个小模型当草稿,大模型做验证。
大模型推理优化核心总结
本文介绍了数据中心、云、端侧部署大模型的主流推理优化手段。NVIDIA 开源库 TensorRT‑LLM 已经集成大量优化:基于 TensorRT 深度学习编译器,搭配高度优化内核、前后处理、多 GPU / 多机通信原语,在 NVIDIA 显卡上实现顶尖推理性能。
TensorRT‑LLM 配合 NVIDIA Dynamo,企业可以在不同框架、硬件、部署形态下同时运行多个 AI 模型,实现高吞吐低延迟。Nemotron‑3、Llama 等开源模型都提供现成 TensorRT‑LLM 配置,GitHub 提供部署示例脚本。